About this service
Potrzebujesz danych ze strony internetowej, ale nie chcesz ich zbierać ręcznie?
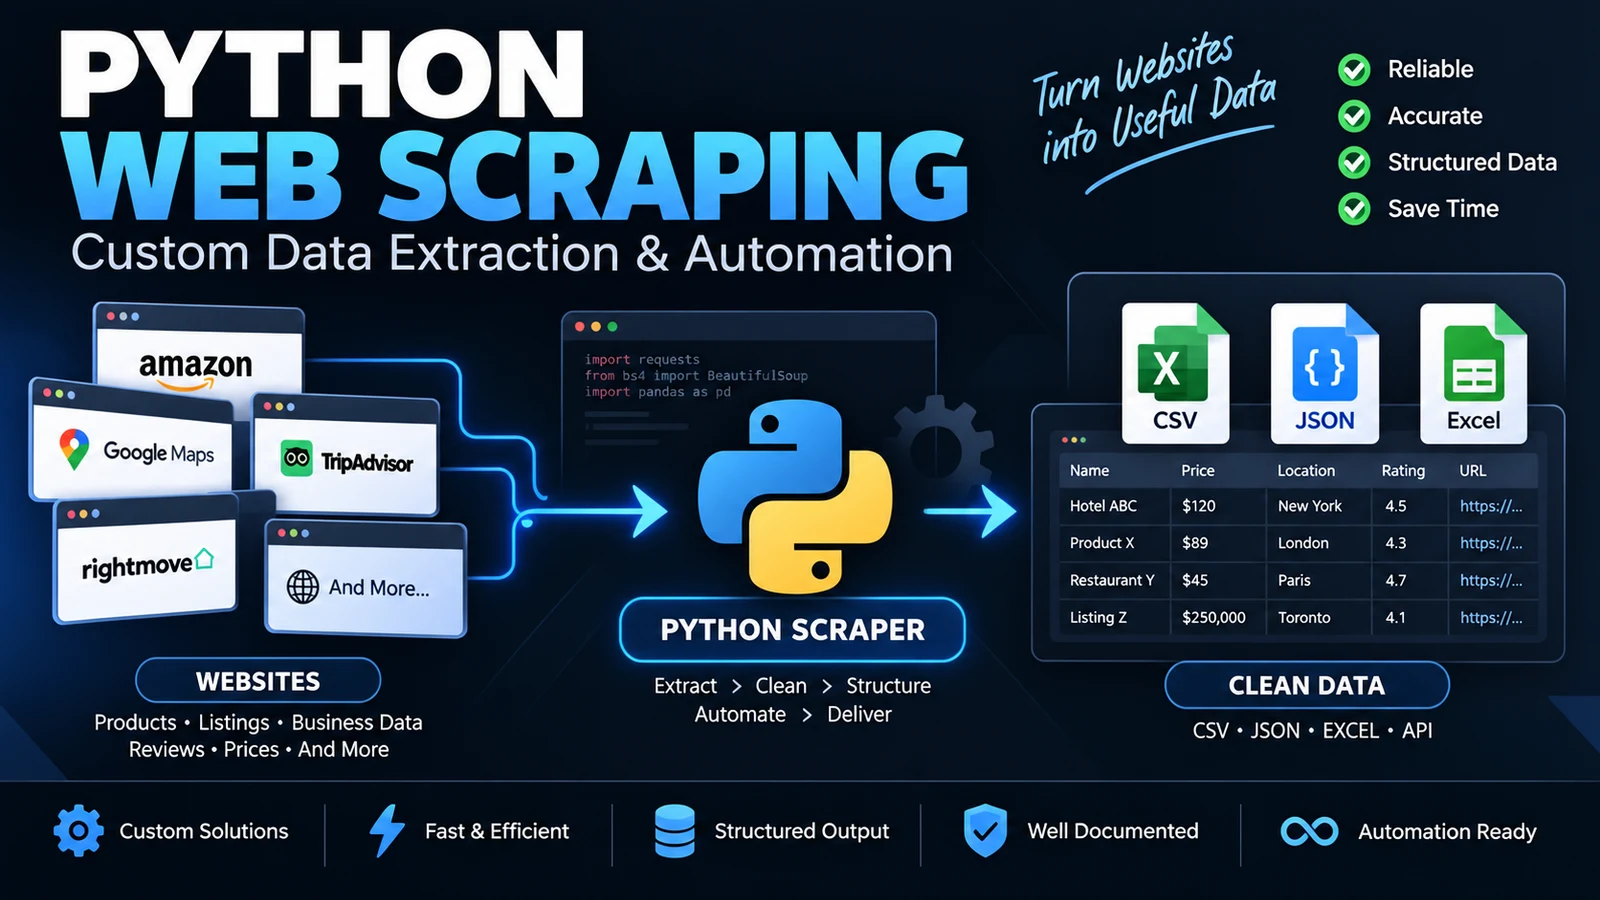
Zbuduję niestandardowego Python web scrapera, który wyodrębni publicznie dostępne dane ze stron internetowych i dostarczy je w czystym, uporządkowanym formacie.
Specjalizuję się w web scrapingu, ekstrakcji danych, automatyzacji przeglądarki oraz backendzie z użyciem Pythona i narzędzi takich jak Requests, BeautifulSoup, Playwright, Selenium oraz FastAPI.
Co mogę wyodrębnić
- Informacje o produktach i ceny
- Oferty nieruchomości
- Katalogi firm
- Dane hoteli i restauracji
- Oferty pracy
- Dane e-commerce
- Wyniki wyszukiwania i publiczne listy
- Recenzje i oceny
- URL-e, obrazy, metadane i inne publicznie dostępne pola
Co otrzymasz
- Niestandardowego Pythona scrapera
- Czyste i uporządkowane dane
- Wynik w formacie CSV, JSON lub Excel w zależności od pakietu
- Kod źródłowy dla odpowiednich pakietów
- Podstawową dokumentację
- Testowanie na uzgodnionej stronie i polach
Proces pracy
1. Podajesz adres strony i wymagane pola danych.
2. Sprawdzam strukturę strony i wymagania dotyczące scrapingu.
3. Buduję i testuję scrapera.
4. Wyodrębniam uzgodnione dane.
5. Czyszczę i porządkuję wynik.
6. Dostarczam scrapera i/lub zestaw danych zgodnie z wybranym pakietem.
Przed zamówieniem
Proszę podać URL strony, dokładne pola danych, przybliżoną liczbę stron/elementów oraz preferowany format wyjściowy. Jeśli strona wymaga logowania, rozwiązywania CAPTCHA, płatnego dostępu lub zawiera dane ograniczone/prywatne, proszę o informację przed zamówieniem.
Know what is included
See the price, delivery time and package details before you start.
Talk to the seller
Ask questions and keep project updates in one conversation.
Check the seller details
Review their profile, experience, skills and languages.
What happens after you start
Choose a package, send the seller the details, and review the finished work from your project page.
- 01
Choose your package
Compare what is included and pick the option that fits your project.
- 02
Send the details
Add your brief, files, examples and anything else the seller needs.
- 03
Review the work
Check the delivery, request an included revision if needed, and approve when you are happy.