About this service
Benötigen Sie Daten von einer Website, möchten diese aber nicht manuell sammeln?
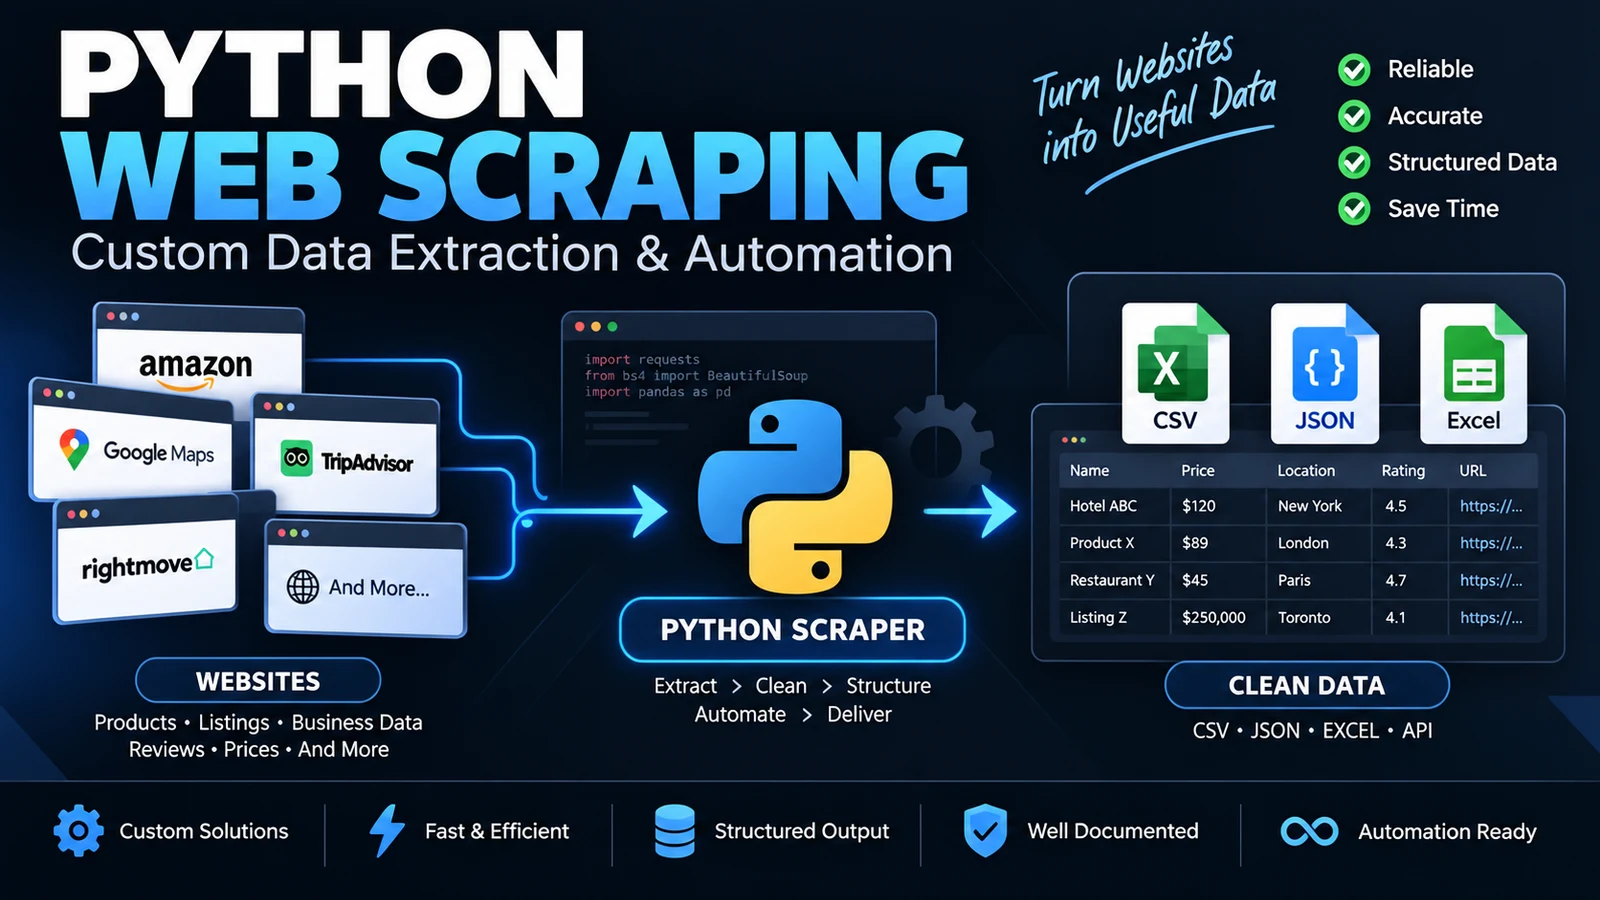
Ich erstelle einen individuellen Python-Web-Scraper, der öffentlich zugängliche Daten von Websites extrahiert und in einem sauberen, strukturierten Format liefert.
Ich spezialisiere mich auf Web-Scraping, Datenerfassung, Browser-Automatisierung und Backend-Entwicklung mit Python und Werkzeugen wie Requests, BeautifulSoup, Playwright, Selenium und FastAPI.
Was ich scrapen kann
- Produktinformationen und Preise
- Immobilienangebote
- Branchenverzeichnisse
- Hotel- und Restaurantdaten
- Stellenanzeigen
- E-Commerce-Daten
- Suchergebnisse und öffentliche Listen
- Bewertungen und Rezensionen
- URLs, Bilder, Metadaten und weitere öffentlich verfügbare Felder
Was Sie erhalten
- Individuellen Python-Scraper
- Sauber und strukturiert extrahierte Daten
- Ausgabe in CSV, JSON oder Excel, je nach Paket
- Quellcode bei entsprechenden Paketen
- Grundlegende Dokumentation
- Tests an der vereinbarten Website und den Datenfeldern
Ablauf
1. Sie nennen die Zielwebsite und die benötigten Datenfelder.
2. Ich prüfe die Website-Struktur und die Anforderungen fürs Scraping.
3. Ich entwickle und teste den Scraper.
4. Ich extrahiere die vereinbarten Daten.
5. Ich bereinige und strukturiere die Ausgabe.
6. Ich liefere den Scraper und/oder Datensatz entsprechend dem gewählten Paket.
Vor der Bestellung
Bitte geben Sie die URL der Website, die genauen benötigten Datenfelder, die ungefähre Anzahl der Seiten/Elemente sowie das bevorzugte Ausgabeformat an. Falls die Website Login, CAPTCHA, kostenpflichtigen Zugang oder eingeschränkte/private Daten erfordert, erwähnen Sie dies bitte vor der Bestellung.
Know what is included
See the price, delivery time and package details before you start.
Talk to the seller
Ask questions and keep project updates in one conversation.
Check the seller details
Review their profile, experience, skills and languages.
What happens after you start
Choose a package, send the seller the details, and review the finished work from your project page.
- 01
Choose your package
Compare what is included and pick the option that fits your project.
- 02
Send the details
Add your brief, files, examples and anything else the seller needs.
- 03
Review the work
Check the delivery, request an included revision if needed, and approve when you are happy.